AIは名寄せをどう変えるのか。データクレンジングやパイプライン構築で威力を発揮する一方、判定においては説明可能かどうかが重要となります。名寄せにおけるAI活用の適切な役割分担と実践的な考え方を解説し、過度な依存を避けるための視点も紹介します。
驚くほど短い期間のうちに、AIは私たちの生活のほぼあらゆる場面に浸透しました。企業間取引であれ消費者向けの取引であれ、かつては人と人とのやり取りだった数多くの場面に、今やAIエージェントが入り込んでいます。その導入は、非常に効率的かつ効果的な場合もあれば(開発者向けのAIコードレビューなど)、もどかしさを覚える場合もあり(学習が不十分なオンラインサポートのチャットボットなど)、さらには大きな失望を招く場合さえあります(AIによる採用面接など)。
用語について:本稿で「AI」という場合、Fellegi-Sunter型の確率モデルや勾配ブースティングによるスコアリングモデルといった従来型の機械学習モデルに基づくマッチングではなく、最先端の大規模言語モデルを指しています。
企業間取引の分野では、「AI革命」がAI導入への大きな圧力を生み出しています。その一部は真の競争優位を求めてのものですが、「取り残されることへの恐れ」によるところも非常に大きいのが実情です。言うまでもなく、この状況はAI企業にとっても、その製品を再販・再パッケージ化する企業にとっても、大変好都合なものです。
私たちがよく受けるご質問の一つに、マスターデータ管理の領域、とりわけ名寄せ(アイデンティティ・レゾリューション。やや不正確ながら「データマッチング」と同一視されることもあります)に対するAIの影響があります。どのような場面でAIを活用すべきで、どのような場面でその過剰な利用に注意すべきなのでしょうか。
名寄せは、次のようなワークフローで構成されます。
- データの取込、クレンジング、標準化
- 候補の生成
- 候補のスコアリング
- 判定
- アクションの実行
- 有用なフィードバックの提供(優れた名寄せシステムの場合)
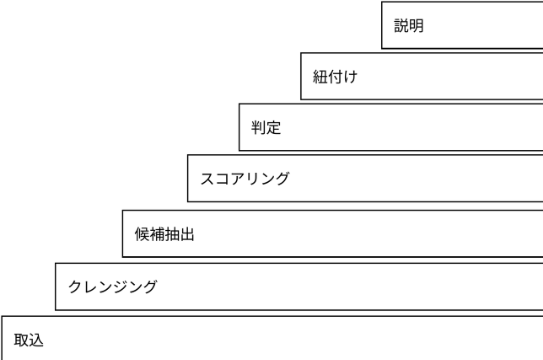
名寄せの技術と理論についてはこれまでの記事でも取り上げてきましたが、今回は、AIが役立つ領域と、AIの影響をむしろ抑えるべき領域に焦点を当てます。
目次
AIの強み
名寄せには、AIが非常に有用で、場合によっては状況を一変させ得る領域があります。
データクレンジング
大量のデータを分析してデータクレンジングのルールを作成するのは、その現実的な一例です。大規模で雑然としたデータセットをAIに与えれば、AIはそのデータをクレンジング・標準化するためのルールを導き出すことができます。ただし、人間の監督者が別途指示しない限り、AIはそうしたルールを膨大な数、しかも個別特化型のものとして作成する傾向があります。AIはいわば「方向性を持たない天才」です。作業の目的や、自らの成果物が自身には想像できない文脈でどのように再利用されるべきかを、真に理解しているわけではありません。この場合のAIは、人の力を何倍にも高める優れた増幅装置であって、人の代わりではありません。そしてこれこそが本稿の中心的な主張です。対象分野に対する人間の深い知見と、AIを訓練・誘導する高い能力があれば、AIによってチームは記録的な速さで卓越した成果を生み出すことができるのです。
データの抽出・変換・格納とデータパイプライン
システム間でデータを移動させる「配管」、すなわちデータパイプラインの構築も、AIが優れた増幅装置となる領域です。ただしここでは、技術スタックやベストプラクティスを非常に明確に規定しておく必要があります。そうしなければ、AIへの度重なる依頼の結果、一貫性のない解決策や技術がスパゲッティのように絡み合った状態になってしまいます。興味深いことに、データの抽出・変換・格納やデータパイプラインのように急速に進化している分野では、まずAIに最新の技術や理論について説明させることが、非常に良い出発点となります。そのうえで戦略を策定し、それをAIに教え込み、遵守させればよいのです。この分野の最近の動向については、 CIO.com の記事(英語)をご参照ください。
人間が担うべき領域
この領域では一般に、AIを「驚くほど博識な物知り」と考えると分かりやすいでしょう。AIはほとんどどんな質問にも自信をもって答えますが、投げかける質問が適切に構成され、曖昧さがなく、明確で有用な答えにつながるものであるよう注意する必要があります。忘れてはならないのは、AIは人間と同じ意味で「知的」なわけではないということです。AIには意識がなく、思考の筋道を頭の中に保持しているわけでもありません。AIは対話のたびに、事実上、文脈を一から把握し直しています。AIは多くの分野について膨大な知識を持ち、「物知り」として、膨大な過去のデータ(いわゆる「学習データ」)から答えを組み立てることができます。そしてこれこそが、AIの限界を理解する鍵でもあります。既存の「ベストプラクティス」を再現したいのであれば、AIは非常に優れた手段です。しかし、まったく新しいものを生み出したい場合や、重要な「固有の文脈」(つまり、皆さまやその企業が世界をどのように捉え、その中でどのように事業を営みたいか)を相当程度含むものを作りたい場合には、そうした作業をAIに任せるのは賢明ではありません。
スキーマ設計
データスキーマ(データの取込、ステージング、変換、保存の各段階におけるデータ構造)の設計は、アーキテクチャの決定をAIに委ねるのがおそらく賢明でない領域です。企業の生命線であるデータのスキーマを設計するには、ビジネス上の文脈、データベースの理論的な概念、さまざまなアーキテクチャ形態の利点と限界を理解したうえで、全般にわたって細部まで細心の注意を払うことが求められます。こうした作業をAIに委ねれば、利用可能で自己完結的な、非常に充実したドキュメントを備えたものが出来上がるでしょう。しかし私たちの考えでは、AIを使わずに一から構築するのと同程度の調整、チューニング、手直しが必要になる可能性が高いのです。
また、「未知への備え」という点でも、人間はどのようなAIよりもはるかに優れています。将来のあらゆるニーズに対応しようとするあまり、データシステムを過剰に設計してしまう(その結果、極めて柔軟ではあるものの性能の低いシステムが出来上がる)という失敗を犯すこともありますが、これはよく知られ、文書化もされている落とし穴であり、通常はピアレビューや周囲からの意見によって解消されます。
判定とフィードバック
データのマッチングとクラスタリングにおいて、何を「許容できる」とするかの判断に至るプロセスは、見た目以上に複雑です。AIにデータセットを渡してマッチングとクラスタリングを依頼すれば、AIはそれを実行します。人間の指導者との試行錯誤を何度か繰り返せば、たとえば90%の確率で正しいとみなされる答えを出すようになるかもしれません。
危険なのは、AIが本質的に説明可能な結果を出さないという点です。AIは結局のところ「ブラックボックス」なのです。最先端の大規模言語モデルの開発者自身でさえ、自らのモデルがなぜ、どのようにして現在のように動作するのかを完全には理解していないと認めています(参照:The New Yorker「What Is Claude? Anthropic Doesn’t Know, Either」)。
これに対しては、「AIに判断の理由を説明させればよい」という反論もあるでしょう。実際、尋ねればAIは流暢に、もっともらしく説明してくれます。しかし、大規模言語モデルの開発者自身による研究が示すように、そうした説明は、実際に答えを左右した要因を反映していないことが少なくありません。Anthropic社の検証では、推論モデルは多くの場合、答えに実際に影響を与えた要因に言及していませんでした(参照:https://www.anthropic.com/research/reasoning-models-dont-say-think)。もっともらしい説明は、監査可能な説明とは異なります。そして、ミッションクリティカルなマッチングにおいて通用するのは後者だけです。
私たちがデータのクラスタリングとマッチングにおいて重視する信条の一つに、「説明できないものは使えない」というものがあります。マッチングシステム(特に顧客データ基盤の分野)は、「確率的」とうたわれていながら、実際にはレーベンシュタイン距離に基づく重み付けスコア程度の単純なアルゴリズムに支えられていることが少なくありません。フィードバックも多くの場合、単純な確信度スコア(1~100など)にすぎませんが、この単純さゆえに、少なくとも結果は説明可能です。つまり、複数のデータがなぜマッチングされ、紐付けられたのかを容易に理解できます(たとえばCDP.comの解説をご参照ください)。とはいえ、こうしたシステムはよくても「切れ味の鈍い道具」になりかねず、だからこそ、はるかに強力で繊細な判断ができるAIが魅力的に映るのです。しかしAIが誤った場合(実際に誤ることはあります)、その後の処理に向けてロジックを決定論的に調整する手段がありません。マッチング対象データの正確性がミッションクリティカルであるならば、目的達成を優先し、時に幻覚(ハルシネーション)を起こすAIが生み出す説明不能な結果は、到底受け入れられるものではありません。
最善のアプローチは、高度で繊細な判断ができ、同時に非常に透明性が高く、それゆえに調整可能なシステムを用いることです。こうした判定を行うロジックは、プラットフォームの力と、自社内で培われた経験、ノウハウ、文脈とを融合したものであるべきです。
まとめと要点
AIは私たちのビジネスの世界を不可逆的に変えました。こうした変化の中には、極めて相乗効果が高く有益なものもあれば、「何でもAIで」という考え方に起因するもので、結果として見当違いな、あるいは有害でさえあるものもあります。データ処理や名寄せも例外ではありません。この分野においても、他のあらゆる分野と同様に、AIの力をうまく活かせるかどうかは、どこでAIを活用するかを見極める判断力にかかっていると私たちは考えます。
名寄せの分野に絞って言えば、エンドツーエンドのマッチングプラットフォームを設計・構築するうえでの適切な役割分担は、おおむね次のようになると私たちは考えます。
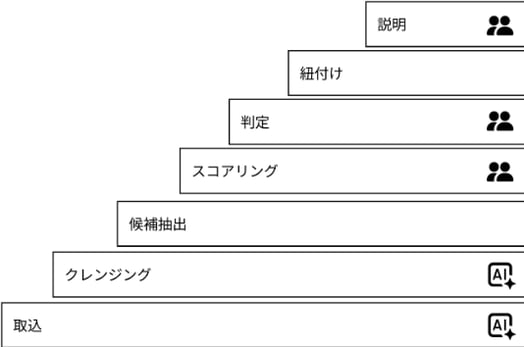
(「候補抽出」と「紐付け」は、主に大量処理を伴う機械的なステップである点にご留意ください。候補抽出は従来、ヒューリスティックな妥協策でした。データベースへの問い合わせや処理中のスコアリングに非常に大きなリソースを要した時代には、システムがすべてをスコアリングすることはできませんでした。そのため、正解をほぼ確実に含む最小限の候補群を抽出する候補抽出アルゴリズムが必要だったのです。現代のコンピューティング環境では、候補を幅広く抽出し、実質的な判断はスコアリングに委ねることができます。そのため、この段階ではAIも人間の判断もあまり付加価値を生みません。)
前述のとおり、AIの力を活用するか否かにかかわらず、名寄せプラットフォームには柔軟性、処理能力、繊細さ、そして文脈への適合性が求められます。この分野の専門家として、CDLは特許取得済みの自社開発名寄せシステムをはじめ、これらすべての原則を体現する技術とプラットフォームを開発してきました。
著者のご紹介
ウオリック・マセウス

ウオリック・マセウス(Warwick Matthews)
最高技術責任者 兼 最高データ責任者
複雑なグローバルデータ、多言語MDM、アイデンティティ解決、「データサプライチェーン」システムの設計、構築、管理において15年以上の専門知識を有し、最高クラスの新システムの構築やサードパーティプラットフォームの統合に従事。 また、最近では大手企業の同意・プライバシー体制の構築にも携わっている。
米国、カナダ、オーストラリア、日本でデータチームを率いた経験があり、 最近では、ロブロー・カンパニーズ・リミテッド(カナダ最大の小売グループ)および米国ナショナル・フットボール・リーグ(NFL)のアイデンティティ・データチームのリーダーとして従事。
アジア言語におけるビジネスIDデータ検証、言語間のヒューリスティック翻字解析、非構造化データのキュレーション、ビジネスから地理のIDデータ検証など、いくつかの分野における特許の共同保有者でもある。